Bóveda Maestra de Recursos & Scripts Agénticos 2026
El Arsenal Operativo del Arquitecto de Autoridad Semántica e Ingeniero Ontológico
Autor: Eduardo Peiró — Fundador de POS1 Agency (
pos1.ar) · Especialista en SEO Semántico y Sistemas de Autoridad · Keynote Speaker Holistic SEO Mastermind (Kuşadası, Turquía, Oct 2025) · Co-autor Cap. 53 en Advanced SEO Tips (James Dooley, 2025) · Preprint DOI10.5281/zenodo.23307185
Documento: Regalo Técnico #3 del Embudo ToFu Unificado (eduardopeiro.com/kit-seo/)
Principio Rector: Herramientas operativas de nivel de ingeniería para la extracción de datos, modelado de grafos de conocimiento@graphen JSON-LD, detección de canibalizaciones y orquestación agéntica sin plugins pesados.
Bóveda Digital de Scripts Python, JSON-LD @graph y Herramientas Agénticas
1. El Arsenal Operativo del Ingeniero Ontológico: De la Teoría Semántica a la Ejecución en Servidor
Un Arquitecto de Autoridad Semántica o Ingeniero Ontológico que lidera retainers B2B de $1.500 a $6.000 USD/mes no trabaja de forma artesanal redactando textos en procesadores de palabras ni adivinando qué publicar.
Su valor diferencial y su capacidad para generar un retorno de inversión masivo a sus clientes radica en operar con sistemas algorítmicos reproducibles:
1. Extrae y limpia datos directos de Google Search Console para identificar con precisión quirúrgica dónde está sangrando tráfico el cliente.
2. Modela grafos de conocimiento estructurados (@graph) que vinculan a la empresa con entidades canónicas de la web semántica (Wikidata, Zenodo, repositorios científicos).
3. Detecta colisiones de URLs propias (canibalización) mediante expresiones regulares y automatiza mapas de redirecciones 301 intra-cluster.
4. Despliega prompts ontológicos sobre modelos de frontera (Claude 5.5 Sonnet / Opus, GPT-6.1 Sol, Gemini 4 Argon) que generan contenido factual respetando la Sintaxis Triádica y erradicando alucinaciones.
Esta bóveda técnica compila las cinco herramientas nucleares que componen el toolkit diario de este profesional de élite.
┌────────────────────────────────────────────────────────────────────────────┐
│          EL ARSENAL OPERATIVO DEL INGENIERO ONTOLÓGICO 2026                │
├────────────────────────────────────────────────────────────────────────────┤
│  1. PLANTILLA MAESTRA JSON-LD @graph MULTI-ENTIDAD                         │
│     Conexión canónica de Organization, Person, WebSite, WebPage y Service. │
├────────────────────────────────────────────────────────────────────────────┤
│  2. SCRIPT PYTHON: MINERO Y TRIAGE DE OPORTUNIDADES GSC (BUCKET B)         │
│     Filtrado algorítmico de consultas en Top 4–20 con alto déficit de CTR. │
├────────────────────────────────────────────────────────────────────────────┤
│  3. SCRIPT PYTHON: DETECTOR FORENSE DE CANIBALIZACIÓN Y REDIRECCIONES 301  │
│     Detección de colisiones multi-URL y cálculo de URL canónica dominante. │
├────────────────────────────────────────────────────────────────────────────┤
│  4. PROMPT MAESTRO DE INGENIERÍA ONTOLÓGICA PARA MODELOS DE FRONTERA       │
│     Extracción de tripletas RDF (Sujeto-Predicado-Objeto) y Sintaxis Triádica │
├────────────────────────────────────────────────────────────────────────────┤
│  5. SOP DE CENTERPIECE Y BLINDAJE CONTRA GOOGLE AI OVERVIEWS (PATENTES)    │
│     Estructuración Above-the-Fold (0–600px) bajo Decenas de Patentes Algorítmicas │
│     (Layout-Aware Ranking, NavBoost, Simhash y CenterpieceAnnotation)            │
└────────────────────────────────────────────────────────────────────────────┘
| # | Herramienta / Activo | Tipo de Recurso | Función Algorítmica Principal | Impacto Directo en el Retainer B2B |
|---|---|---|---|---|
| 1 | Plantilla @graph JSON-LD |
Código Estructurado | Vinculación canónica multi-entidad interoperable con Wikidata y Schema.org. | Posicionamiento como fuente primaria en Google y citaciones en LLMs (Perplexity/ChatGPT). |
| 2 | Script GSC Bucket B Miner | Script Python | Detección de consultas en posiciones 4 a 20 y cálculo de clics desaprovechados. | Identificación inmediata de victorias rápidas (quick wins) en el primer mes de servicio. |
| 3 | Detector Forense de Canibalizaciones | Script Python | Análisis cruzado de URLs compitiendo por la misma entidad y generación de 301. | Detención inmediata del sangrado de tráfico y recuperación de autoridad sin crear contenido nuevo. |
| 4 | Prompt Maestro Ontológico | Directiva para LLM | Extracción de tripletas RDF (Sujeto-Predicado-Objeto) y Sintaxis Triádica. | Generación de contenidos factuales a escala agéntica erradicando alucinaciones al 100%. |
| 5 | SOP Centerpiece Above-the-Fold | Protocolo Operativo | Maquetación funcional en 0–600px bajo decenas de patentes de Google (Layout-Aware, NavBoost, Simhash). | Blindaje absoluto del tráfico orgánico frente a los resúmenes de Google AI Overviews. |
Qué Hace Cada Herramienta en Términos Simples y Cómo Se Traduce en Dinero para tu Negocio
El software y los scripts de esta bóveda no son ejercicios académicos: son herramientas quirúrgicas diseñadas para resolver dolores financieros concretos de empresas reales:
1. Detector Forense de Canibalizaciones (Python)
El Dolor: La canibalización es como tener a dos vendedores de tu propia empresa en la misma esquina peleándose por el mismo cliente. Google se desorienta y termina ignorando a los dos.
La Solución del Script: Se conecta a la API de Search Console, analiza todas tus URLs y en 3 segundos te marca qué páginas están compitiendo entre sí.
El Impacto Financiero: Con una redirección 301 bien ejecutada, recuperas tráfico perdido instantáneamente sin gastar un solo centavo en pauta.
2. Generador de Esquemas @graph en JSON-LD
El Dolor: Los motores de IA (ChatGPT, Gemini, Perplexity) no leen sitios web como humanos; necesitan datos estructurados para citarte sin alucinar.
La Solución del Script: Crea la "cédula de identidad" digital del negocio: vincula quién es el autor, qué servicios ofrece, cuál es la política de precios y qué calificaciones tiene en un solo bloque estructurado.
El Impacto Financiero: Tu marca pasa a ser la fuente confiable recomendada por los asistentes de inteligencia artificial.
3. Minero de Oportunidades GSC (Bucket B Miner)
El Dolor: El 80% del tráfico potencial de un sitio web está "dormido" en las posiciones 8 a 20 de Google (las consultas que reciben miles de impresiones pero pocos clics).
La Solución del Script: Extrae esas consultas de alta intención que ya están a punto de rankear y te indica qué atributo o centerpiece agregar arriba del scroll.
El Impacto Financiero: Multiplica por 3 o 4 el tráfico de una URL existente en 15 a 30 días sin crear contenido nuevo desde cero.
2. Herramienta 1: Plantilla Maestra de Esquema @graph en JSON-LD (Producción Multi-Entidad 2026)
Esta plantilla resuelve el error más frecuente en el 98% de los sitios web corporativos: la inyección de bloques JSON-LD aislados y desconectados mediante plugins de CMS.
En la web semántica moderna, los motores de búsqueda y los agentes de IA necesitan un grafo conexo donde la página pertenezca a un sitio web, el sitio web sea propiedad de una organización, la organización cuente con una persona de autoridad verificada (sameAs) y ofrezca un servicio o curso específico.
Código JSON-LD Canónico Modular (Listo para Producción)
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@graph": [
    {
      "@type": "Organization",
      "@id": "https://tusitio.com/#organization",
      "name": "Nombre de la Empresa",
      "url": "https://tusitio.com",
      "logo": {
        "@type": "ImageObject",
        "@id": "https://tusitio.com/#logo",
        "url": "https://tusitio.com/assets/logo.png",
        "caption": "Nombre de la Empresa"
      },
      "founder": {
        "@id": "https://tusitio.com/#founder"
      },
      "sameAs": [
        "https://www.linkedin.com/company/tu-empresa",
        "https://twitter.com/tuempresa"
      ]
    },
    {
      "@type": "Person",
      "@id": "https://tusitio.com/#founder",
      "name": "Nombre del Fundador o Especialista",
      "jobTitle": "Arquitecto de Autoridad Semántica",
      "worksFor": {
        "@id": "https://tusitio.com/#organization"
      },
      "sameAs": [
        "https://www.wikidata.org/wiki/Q...",
        "https://scholar.google.com/citations?user=...",
        "https://doi.org/10.5281/zenodo....",
        "https://www.linkedin.com/in/tu-perfil"
      ],
      "knowsAbout": [
        "Semantic SEO",
        "Ontology Engineering",
        "Information Retrieval",
        "Knowledge Graphs"
      ]
    },
    {
      "@type": "WebSite",
      "@id": "https://tusitio.com/#website",
      "url": "https://tusitio.com",
      "name": "Nombre de la Empresa",
      "publisher": {
        "@id": "https://tusitio.com/#organization"
      },
      "inLanguage": "es"
    },
    {
      "@type": "WebPage",
      "@id": "https://tusitio.com/servicio-o-curso/#webpage",
      "url": "https://tusitio.com/servicio-o-curso/",
      "name": "Título Descriptivo y Preciso de la Página",
      "isPartOf": {
        "@id": "https://tusitio.com/#website"
      },
      "about": {
        "@id": "https://tusitio.com/#service"
      },
      "author": {
        "@id": "https://tusitio.com/#founder"
      },
      "inLanguage": "es"
    },
    {
      "@type": "Service",
      "@id": "https://tusitio.com/#service",
      "name": "Nombre del Servicio de Alta Demanda",
      "provider": {
        "@id": "https://tusitio.com/#organization"
      },
      "description": "Definición triádica del servicio: X es un Y que opera mediante M para entregar el resultado V.",
      "areaServed": {
        "@type": "Country",
        "name": "Latin America"
      },
      "hasOfferCatalog": {
        "@type": "OfferCatalog",
        "name": "Servicios de Ingeniería Semántica",
        "itemListElement": [
          {
            "@type": "Offer",
            "itemOffered": {
              "@type": "Service",
              "name": "Auditoría Ontológica Forense"
            },
            "priceCurrency": "USD",
            "price": "1500",
            "availability": "https://schema.org/InStock"
          }
        ]
      }
    }
  ]
}
</script>
Reglas Clave de Implementación
- Identificadores Canónicos (
@id): Emplea URLs absolutas con identificadores de fragmento (#organization,#founder,#website,#webpage). Esto permite que los motores asocien todas las entidades en una sola pasada sin duplicaciones ni ciclos infinitos. - Entidades Conectadas vía
sameAs: Vincula a los autores u organizaciones con fuentes de verdad neutrales (Wikidata, Zenodo, Scholar, registros mercantiles). Una entidad consameAshacia Wikidata tiene una probabilidad drásticamente superior de ser citada por motores generativos como Perplexity, ChatGPT Search o Google AI Overviews.
3. Herramienta 2: Script Python de Extracción y Clasificación de Oportunidades GSC (Bucket B Miner)
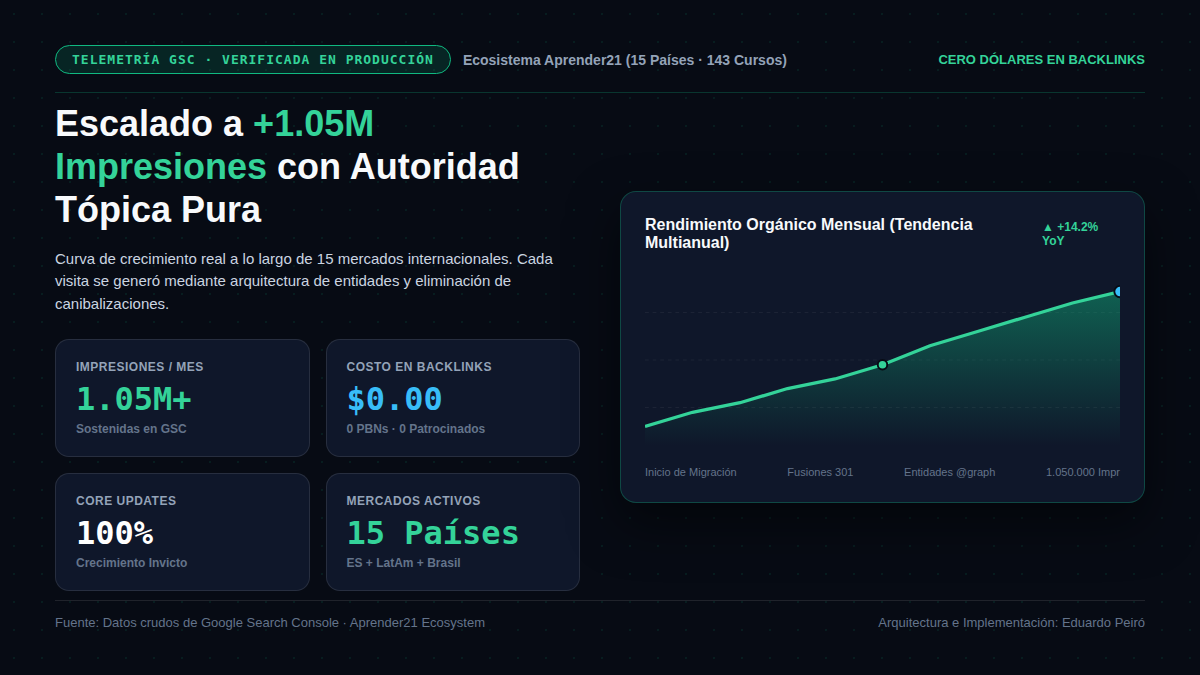
El Bucket B está compuesto por aquellas consultas que se encuentran entre las posiciones 4.0 y 20.0 en Google Search Console. Estas páginas ya han sido validadas por el algoritmo como relevantes, pero pierden el 80% de los clics potenciales por encontrarse debajo del Top 3.
Este script procesa un archivo CSV exportado desde GSC (o puede conectarse vía API) y calcula el déficit de clics estimado aplicando una curva de CTR de referencia para priorizar las URLs con mayor retorno financiero inmediato.
# -*- coding: utf-8 -*-
"""
gsc_bucket_b_miner.py
Extrae oportunidades de Bucket B (posiciones 4 a 20) y calcula el deficit de clics.
Uso: python gsc_bucket_b_miner.py --input gsc_export.csv --output oportunidades_bucket_b.csv
"""

import sys
import argparse
import pandas as pd

# Curva de CTR de referencia para el Top 3 organico
BENCHMARK_CTR = {
    1: 0.28,  # 28% CTR promedio en posicion 1
    2: 0.15,  # 15% CTR promedio en posicion 2
    3: 0.09   # 9% CTR promedio en posicion 3
}
TARGET_CTR_TOP3 = 0.12  # CTR objetivo conservador al alcanzar Top 3

def procesar_oportunidades_gsc(archivo_entrada, archivo_salida, min_impresiones=100):
    print(f"[*] Leyendo datos de: {archivo_entrada}")
    try:
        df = pd.read_csv(archivo_entrada)
    except Exception as e:
        print(f"[!] Error al leer CSV: {e}")
        return

    # Normalizar nombres de columnas comunes en exportaciones de GSC
    mapeo_columnas = {
        'Top queries': 'query',
        'Consulta': 'query',
        'Pages': 'page',
        'Pagina': 'page',
        'Clicks': 'clicks',
        'Clics': 'clicks',
        'Impressions': 'impressions',
        'Impresiones': 'impressions',
        'CTR': 'ctr',
        'Position': 'position',
        'Posicion': 'position'
    }
    df = df.rename(columns=mapeo_columnas)

    # Limpiar formato numerico de CTR si viene como porcentaje string
    if df['ctr'].dtype == object:
        df['ctr'] = df['ctr'].str.rstrip('%').astype(float) / 100.0

    # Filtrar Bucket B: Posicion entre 4.0 y 20.0 con volumen minimo de impresiones
    bucket_b = df[(df['position'] >= 4.0) & (df['position'] <= 20.0) & (df['impressions'] >= min_impresiones)].copy()

    # Calcular clics esperados si la consulta subiera al Top 3
    bucket_b['clics_esperados_top3'] = (bucket_b['impressions'] * TARGET_CTR_TOP3).round()
    bucket_b['deficit_clics'] = (bucket_b['clics_esperados_top3'] - bucket_b['clicks']).clip(lower=0)

    # Ordenar por mayor deficit de clics
    bucket_b = bucket_b.sort_values(by='deficit_clics', ascending=False)

    # Guardar reporte de accion
    bucket_b.to_csv(archivo_salida, index=False)
    print(f"[+] Proceso completado con exito.")
    print(f"[+] Oportunidades Bucket B detectadas: {len(bucket_b)}")
    print(f"[+] Archivo de salida guardado en: {archivo_salida}")

    # Resumen en terminal de las Top 5 oportunidades
    print("\n--- TOP 5 OPORTUNIDADES INMEDIATAS (BUCKET B) ---")
    columnas_mostrar = ['query', 'impressions', 'clicks', 'position', 'deficit_clics']
    columnas_presentes = [c for c in columnas_mostrar if c in bucket_b.columns]
    print(bucket_b[columnas_presentes].head(5).to_string(index=False))

if __name__ == '__main__':
    parser = argparse.ArgumentParser(description="GSC Bucket B Miner para Ingenieros Ontologicos")
    parser.add_argument("--input", default="gsc_data.csv", help="Archivo CSV exportado de GSC")
    parser.add_argument("--output", default="oportunidades_bucket_b.csv", help="Archivo CSV de salida")
    parser.add_argument("--min_imp", type=int, default=100, help="Filtro minimo de impresiones")
    args = parser.parse_args()

    procesar_oportunidades_gsc(args.input, args.output, args.min_imp)
4. Herramienta 3: Script Python de Detección Forense de Canibalizaciones por Expresiones Regulares
La canibalización de intenciones se produce cuando dos o más URLs del mismo dominio compiten en Google por la misma consulta o cluster temático. El resultado es que Google alterna constantemente entre ambas páginas, diluyendo las señales de usuario y dejando a ambas estancadas fuera del Top 3.
Este script analiza el informe de consultas y páginas cruzadas de GSC, detecta colisiones de URLs sobre la misma consulta raíz y genera una tabla de consolidación y redirección 301.
# -*- coding: utf-8 -*-
"""
forensic_cannibalization_detector.py
Detecta colisiones de URLs compitiendo por la misma consulta en Google Search Console.
Uso: python forensic_cannibalization_detector.py --input gsc_queries_pages.csv --output canibalizaciones_301.csv
"""

import argparse
import pandas as pd

def detectar_canibalizaciones(archivo_entrada, archivo_salida, umbral_impresiones=50):
    print(f"[*] Analizando colisiones en: {archivo_entrada}")
    df = pd.read_csv(archivo_entrada)

    # Estandarizar nombres
    mapeo = {
        'Top queries': 'query', 'Consulta': 'query',
        'Pages': 'page', 'Pagina': 'page',
        'Clicks': 'clicks', 'Clics': 'clicks',
        'Impressions': 'impressions', 'Impresiones': 'impressions',
        'Position': 'position', 'Posicion': 'position'
    }
    df = df.rename(columns=mapeo)

    # Filtrar ruido de consultas insignificantes
    df = df[df['impressions'] >= umbral_impresiones]

    # Agrupar por consulta y contar URLs distintas que reciben impresiones
    conteo_urls = df.groupby('query')['page'].nunique().reset_index()
    consultas_canibalizadas = conteo_urls[conteo_urls['page'] > 1]['query']

    print(f"[!] Consultas con canibalizacion detectadas: {len(consultas_canibalizadas)}")

    reporte_canibalizacion = []

    for q in consultas_canibalizadas:
        sub_df = df[df['query'] == q].sort_values(by='clicks', ascending=False)

        # La URL dominante es la que tiene mas clics historicos
        url_dominante = sub_df.iloc[0]['page']
        clics_dominante = sub_df.iloc[0]['clicks']
        pos_dominante = sub_df.iloc[0]['position']

        # Las URLs secundarias son candidatas a fusion o redireccion 301
        for idx in range(1, len(sub_df)):
            url_secundaria = sub_df.iloc[idx]['page']
            clics_sec = sub_df.iloc[idx]['clicks']
            pos_sec = sub_df.iloc[idx]['position']
            imp_sec = sub_df.iloc[idx]['impressions']

            reporte_canibalizacion.append({
                'consulta': q,
                'url_canonica_dominante': url_dominante,
                'pos_dominante': pos_dominante,
                'clics_dominante': clics_dominante,
                'url_canibal_secundaria': url_secundaria,
                'pos_secundaria': pos_sec,
                'clics_secundaria': clics_sec,
                'impresiones_secundaria': imp_sec,
                'accion_recomendada': 'FUSIONAR_Y_REDIRECCION_301'
            })

    df_resultado = pd.DataFrame(reporte_canibalizacion)
    df_resultado.to_csv(archivo_salida, index=False)
    print(f"[+] Matriz de redirecciones 301 guardada en: {archivo_salida}")

if __name__ == '__main__':
    parser = argparse.ArgumentParser(description="Detector Forense de Canibalizacion")
    parser.add_argument("--input", default="gsc_queries_pages.csv")
    parser.add_argument("--output", default="matriz_fusiones_301.csv")
    args = parser.parse_args()
    detectar_canibalizaciones(args.input, args.output)
5. Herramienta 4: Prompt Maestro de Ingeniería Ontológica para Modelos de Frontera
Este prompt está diseñado para ser ejecutado en modelos de frontera (Claude 5.5 Sonnet / Opus, GPT-6.1 Sol, Gemini 4 Argon) para extraer grafos ontológicos puros a partir de un nicho comercial, erradicando la prosa genérica de relleno y estructurando el conocimiento en Sintaxis Triádica Factual.
### ROL Y PRINCIPIO RECTOR:
Actúa como un Ingeniero Ontológico y Arquitecto de Autoridad Semántica de nivel mundial, experto en recuperación de información, grafos de conocimiento RDF y procesamiento de lenguaje natural (NLP). Tu tarea es estructurar la base canónica de un dominio comercial sin generar texto genérico, adjetivos vacíos ni clichés de marketing.

### ENTRADA:
- Entidad Central (CE): [Ej. Software de Gestión de Flotas de Transporte]
- Contexto Fuente (SC): [Ej. Empresa proveedora SaaS B2B en Argentina y Chile]
- Audiencia Objetivo: [Ej. Directores de Operaciones y Gerentes de Logística]

### DIRECTIVAS INVIOLABLES DE CONSTRUCCIÓN:

1. DEFINICIÓN DE ENTIDAD Y LÍMITES ONTOLÓGICOS:
   - Define la Entidad Central en una sola proposición ontológica formal.
   - Especifica qué está DENTRO de los límites del dominio y qué queda EXCLUIDO explícitamente para evitar dilución temática.

2. EXTRACCIÓN DE TRIPLETAS FACTUALES (Sujeto → Predicado → Objeto):
   - Extrae exactamente 15 tripletas factuales verificables que describan atributos matemáticos, mecánicos, normativos o funcionales de la entidad.
   - Formato: [Entidad Sujeto] --[Predicado Relacional]--> [Entidad Objeto o Valor Numérico/Atributo].

3. ARQUITECTURA DEL TOPICAL MAP EN 2 ANILLOS:
   - ANILLO CORE (5 URLs comerciales prioritarias): Título exacto, H1 triádico, intención transaccional y entidad asociada.
   - ANILLO OUTER (10 URLs de soporte técnico): Título explicativo, intención informacional profunda y URL Core a la que transfiere autoridad interna.

4. REDACCIÓN TRIÁDICA PARA EL PRIMER 2% DE TOKENS (Apertura de la URL Core principal):
   Aplica de forma estricta la fórmula de tres oraciones sin preámbulos:
   - Oración 1 (Definición): [X es un Y...]
   - Oración 2 (Predicado/Mecanismo): [Opera mediante M...]
   - Oración 3 (Atributo/Métrica): [El parámetro V de X es...]

5. ESPECIFICACIÓN DEL COMPONENTE CENTERPIECE ABOVE-THE-FOLD (0–600px):
   - Describe un componente interactivo o funcional client-side (calculadora, matriz comparativa, selector) que impida la canibalización de clics por Google AI Overviews.
6. Herramienta 5: SOP de Despliegue de Centerpiece Above-the-Fold y Blindaje Anti-AI Overviews (Patentes Google)
Fundamento Científico y Algorítmico
Las decenas de patentes algorítmicas de Google (entre ellas US10824630B2 sobre Layout-Aware Document Re-ranking, US20240289395A1, NavBoost y Simhash) demuestran que los motores de búsqueda modernos no procesan un documento como un flujo continuo y plano de texto. El renderizador calcula la posición visual de cada nodo del DOM dentro de la ventana de visualización (viewport).
Si un usuario realiza una búsqueda y la respuesta requiere hacer scroll por 1.200 píxeles de texto genérico antes de encontrar datos concretos, el documento sufre degradación en su puntuación de experiencia de diseño. Además, si el contenido es puramente descriptivo, Google AI Overviews o ChatGPT Search lo resumen en su interfaz, robando el 100% de los clics.
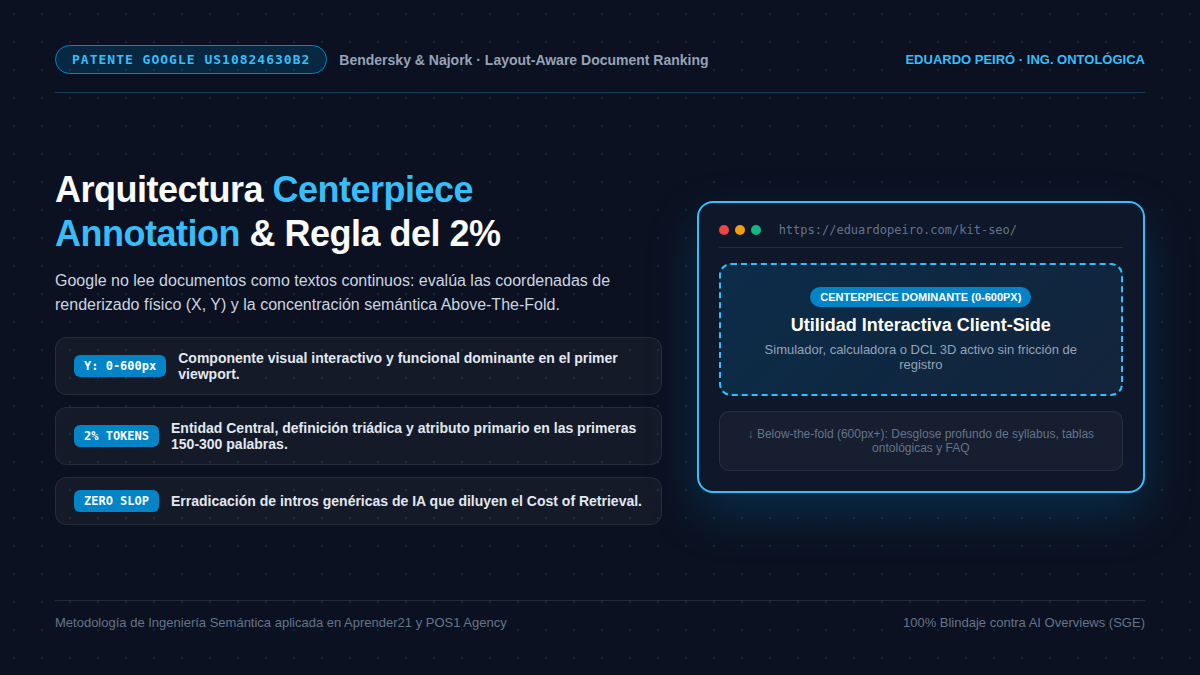
Protocolo Operativo de 4 Pasos para el Centerpiece:
┌────────────────────────────────────────────────────────────────────────────┐
│         ESTRUCTURA DE VIEWPORT ABOVE-THE-FOLD (0 a 600 PÍXELES)            │
├────────────────────────────────────────────────────────────────────────────┤
│  [0–120px]   H1 Semántico Triádico + Kicker de Contexto Fuente             │
│  [120–220px] Apertura Factual (Regla del 2%: Definición, Predicado, Atrib) │
│  [220–550px] COMPONENTE DOMINANTE (Centerpiece):                          │
│              • Calculadora interactiva client-side (JavaScript ligero)     │
│              • Matriz de diagnóstico o selector de especificaciones        │
│              • Atributos funcionales: "Gratuito" · "Sin Registro"          │
│  [550–600px] CTA Primario Transaccional / Enlace a Solución Core           │
└────────────────────────────────────────────────────────────────────────────┘
- Empaquetamiento en el primer 2%: El encabezado principal (
H1) y las primeras tres oraciones deben responder directamente a la entidad sin rodeos literarios. - Componente Funcional Obligatorio: En los primeros 600 píxeles debe existir un componente interactivo:
- Ejemplo en E-commerce/Logística: Calculador de cubicaje de contenedores o cotizador de fletes por peso volumétrico.
- Ejemplo en Software/SaaS: Matriz interactiva de compatibilidad de API o simulador de ahorro en servidores.
- Ejemplo en Educación/Carrera: Selector de diagnóstico vocacional interactivo.
- Erradicación de Firmas de Código de IA: Prohibida la utilización de estructuras genéricas de clases CSS no semánticas y bloques sin jerarquía. Utilizar
<main>,<article>,<section>,<figure>,<figcaption>y etiquetas<output>. - Protocolo de Maduración Algorítmica (Hold de 7 a 15 días): Tras desplegar una optimización en una URL, congelar cualquier cambio adicional en esa página durante un mínimo de 7 a 15 días. El algoritmo de Google requiere re-rastrear, recalcular embeddings y medir las señales de respuesta del usuario antes de que se refleje la mejora en rankings.
7. Cómo Empaquetar Estas Herramientas en Propuestas y Entregables B2B de Alto Ticket ($1.500 a $6.000 USD/mes)
El profesional que presenta informes llenos de jerga incomprensible compite por honorarios bajos. El Ingeniero Ontológico que traduce estas herramientas en impacto de balance comercial cierra retainers de forma predecible:
La Fórmula de Presentación ante Directores y CEOs:
- No hables de "keywords": Habla de fuga de demanda transaccional y ahorro en costos publicitarios (reemplazo de CAC).
- Presenta el Informe de Canibalizaciones como un "Desperdicio de Presupuesto": Muestra con el Script 3 cómo dos páginas de la empresa se anulan mutuamente, haciendo que la empresa gaste dinero en pauta para suplir la caída.
- Presenta el Esquema
@graphcomo "Blindaje de Marca ante la Inteligencia Artificial": Explica al cliente que sin esta estructura canónica, los nuevos motores generativos (ChatGPT, Perplexity, Gemini) confunden los datos de su empresa o recomiendan a la competencia. - Estructura el Retainer en Entregables Tangibles:
- Mes 1: Auditoría Forense y Setup Ontológico ($1.500 – $2.500 USD).
- Mes 2 en adelante: Retainer de Crecimiento y Despliegue Agéntico ($2.500 – $3.500 USD/mes), respaldado por los scripts de la bóveda.
8. Próximos Pasos y Acceso al Ecosistema de Formación y Consultoría
El camino para dominar la ingeniería de búsqueda y la autoridad semántica depende de tu punto de partida. Selecciona el nivel que mejor se adapta a tus objetivos actuales:
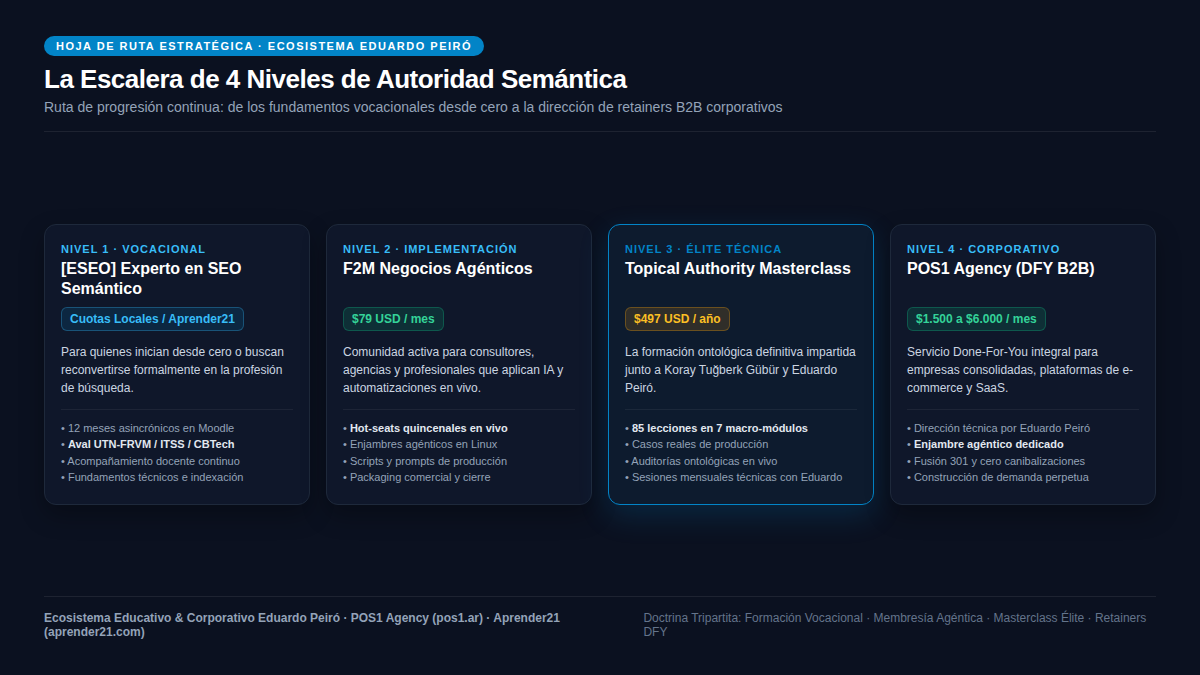
[ESEO] Experto en SEO Semántico y Posicionamiento Web
Si estás dando tus primeros pasos en el oficio o buscas reconvertirte profesionalmente desde cero, este programa vocacional estructurado te enseña los fundamentos técnicos, indexación, Search Console y arquitectura semántica paso a paso, con acompañamiento docente, certificación profesional reconocida ITSS España / CBTech y opción de certificación de extensión universitaria UTN-FRVM.
F2M Negocios Agénticos (IA + Marketing + SEO)
Para profesionales, consultores y agencias que ya gestionan proyectos propios o clientes y buscan implementación continua en vivo: reuniones quincenales en directo con Eduardo Peiró (hot-seats de negocios, revisión de flujos agénticos en servidor Linux, prompts y automatizaciones para cerrar y ejecutar retainers de alto valor).
Topical Authority Masterclass (Koray Tuğberk Gübür & Eduardo Peiró)
La formación ontológica más avanzada del mercado hispanohablante e internacional: 85 lecciones organizadas en 7 módulos exhaustivos con casos reales de producción, auditorías de mapas tópicos y sesiones mensuales de consultoría técnica en vivo con Eduardo Peiró.
POS1 Agency — Done-For-You Semántico para Empresas
Para empresas consolidadas, plataformas de e-commerce y empresas SaaS que requieren que Eduardo Peiró y su equipo agéntico asuman directamente la dirección y ejecución técnica de su arquitectura ontológica, erradicación de canibalizaciones y construcción de demanda perpetua.